
追踪 AI 安全新闻、论文与事件。一站阅读,也能接入你的 Agent。


打开观测台 · 实时新闻 · 找论文 · 读日报 · 接入 Agent
AI Safety HOT 持续整理越狱、提示注入、Agent 安全、防御与护栏、对齐、评测、真实事件和治理政策。网站提供中英文阅读;这个 Hub 保存公开论文清单、日报归档和 Agent 技能。
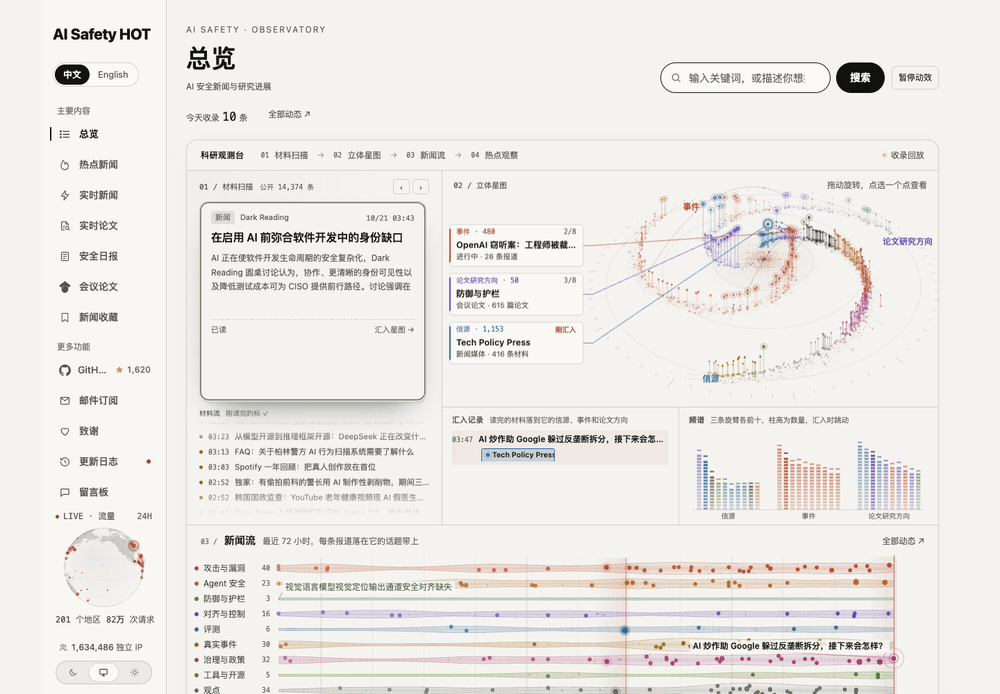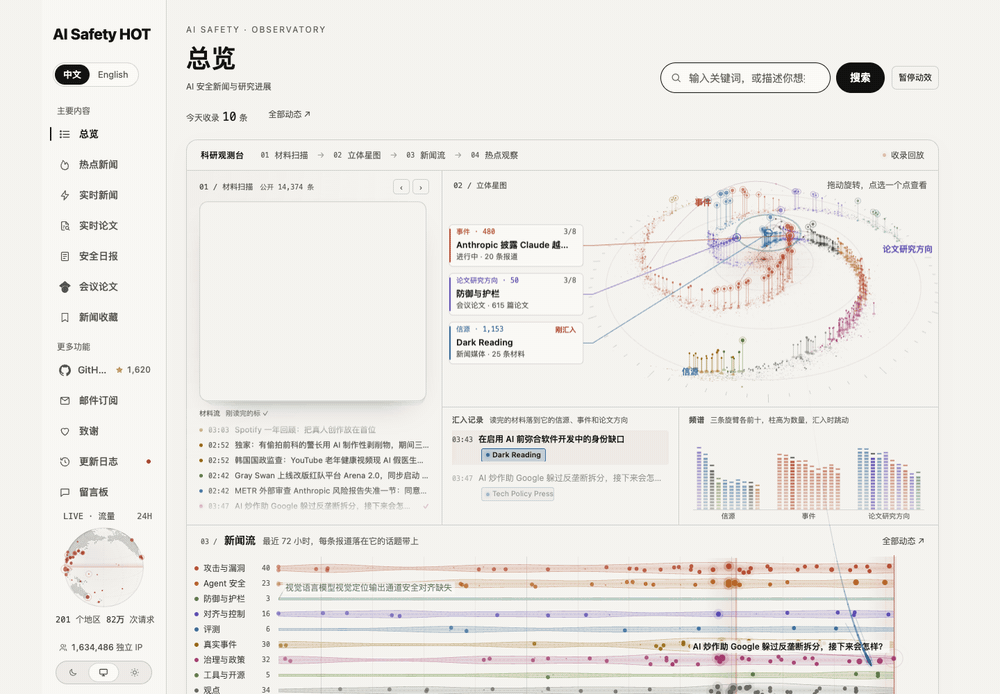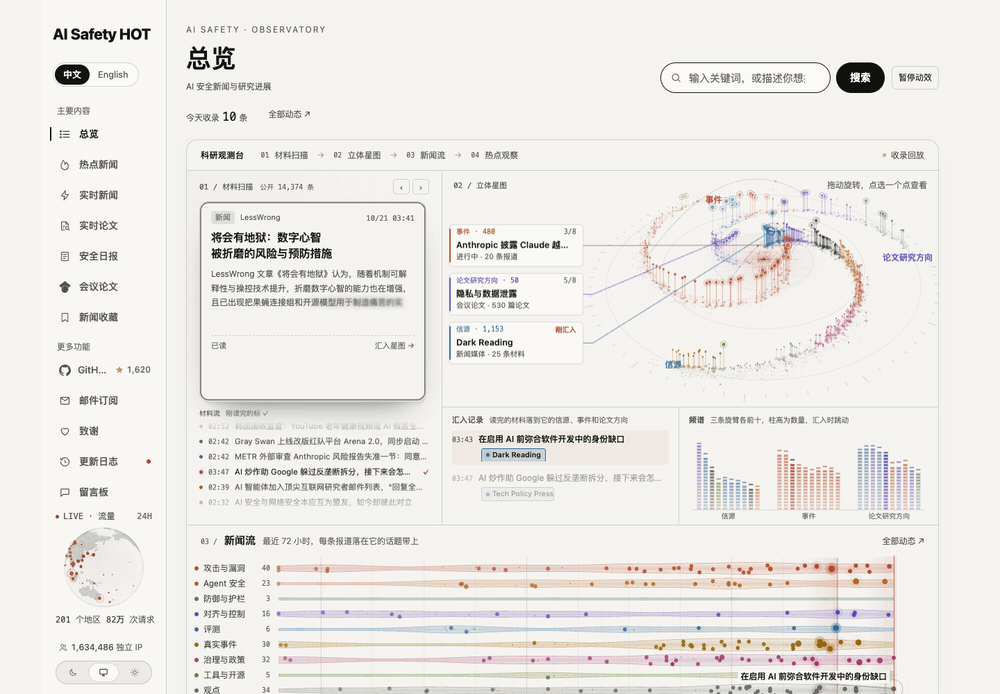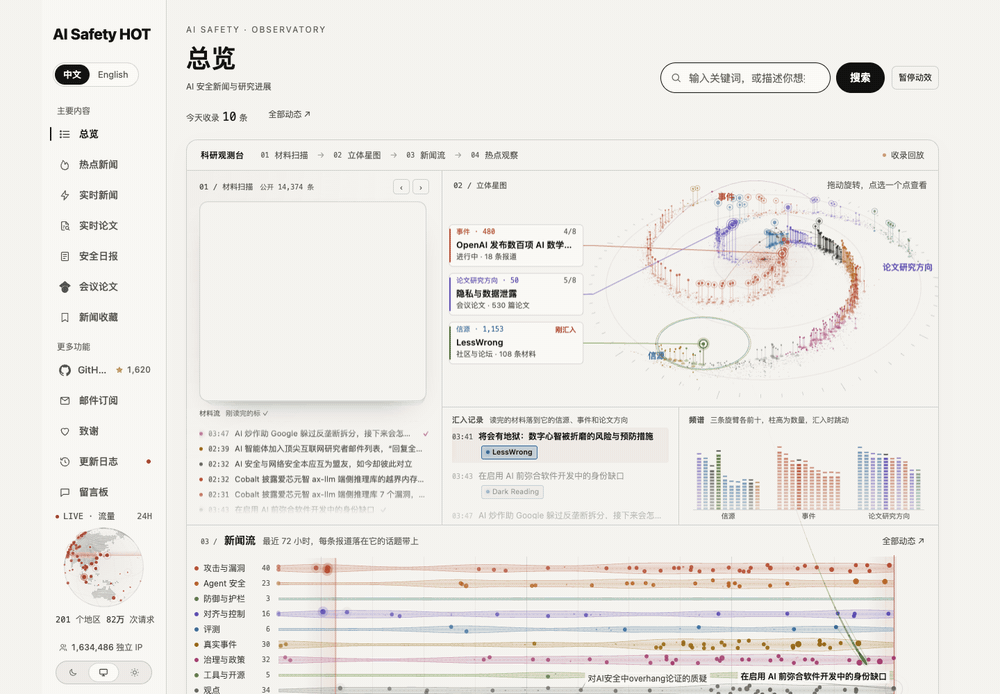
首页是一座可以探索的科研观测台:材料卡片逐条扫描,汇入由信源、事件和论文研究方向组成的立体星图;往下是最近 72 小时的新闻流,以及汇集报道与社区讨论的热点观察。拖动星图旋转,点选节点,沿链接继续阅读。
上面的 GIF 来自真实网站录屏。查看高清静态图 · 查看新闻流与热点观察
| 想看什么 | 从这里开始 |
|---|---|
| 最近发生了什么 | 实时新闻:浏览动态、阅读导读,回到原文。 |
| 一件事怎样发展 | 热点新闻:把相关报道放在一起,查看事件进展与讨论。 |
| 一个方向有哪些研究 | 实时论文与会议论文:按研究方向筛选,查看题录、速读和原文。 |
| 每天集中读一遍 | 安全日报:按方向整理,当天的新进展补进同一期。 |
展开新版页面截图
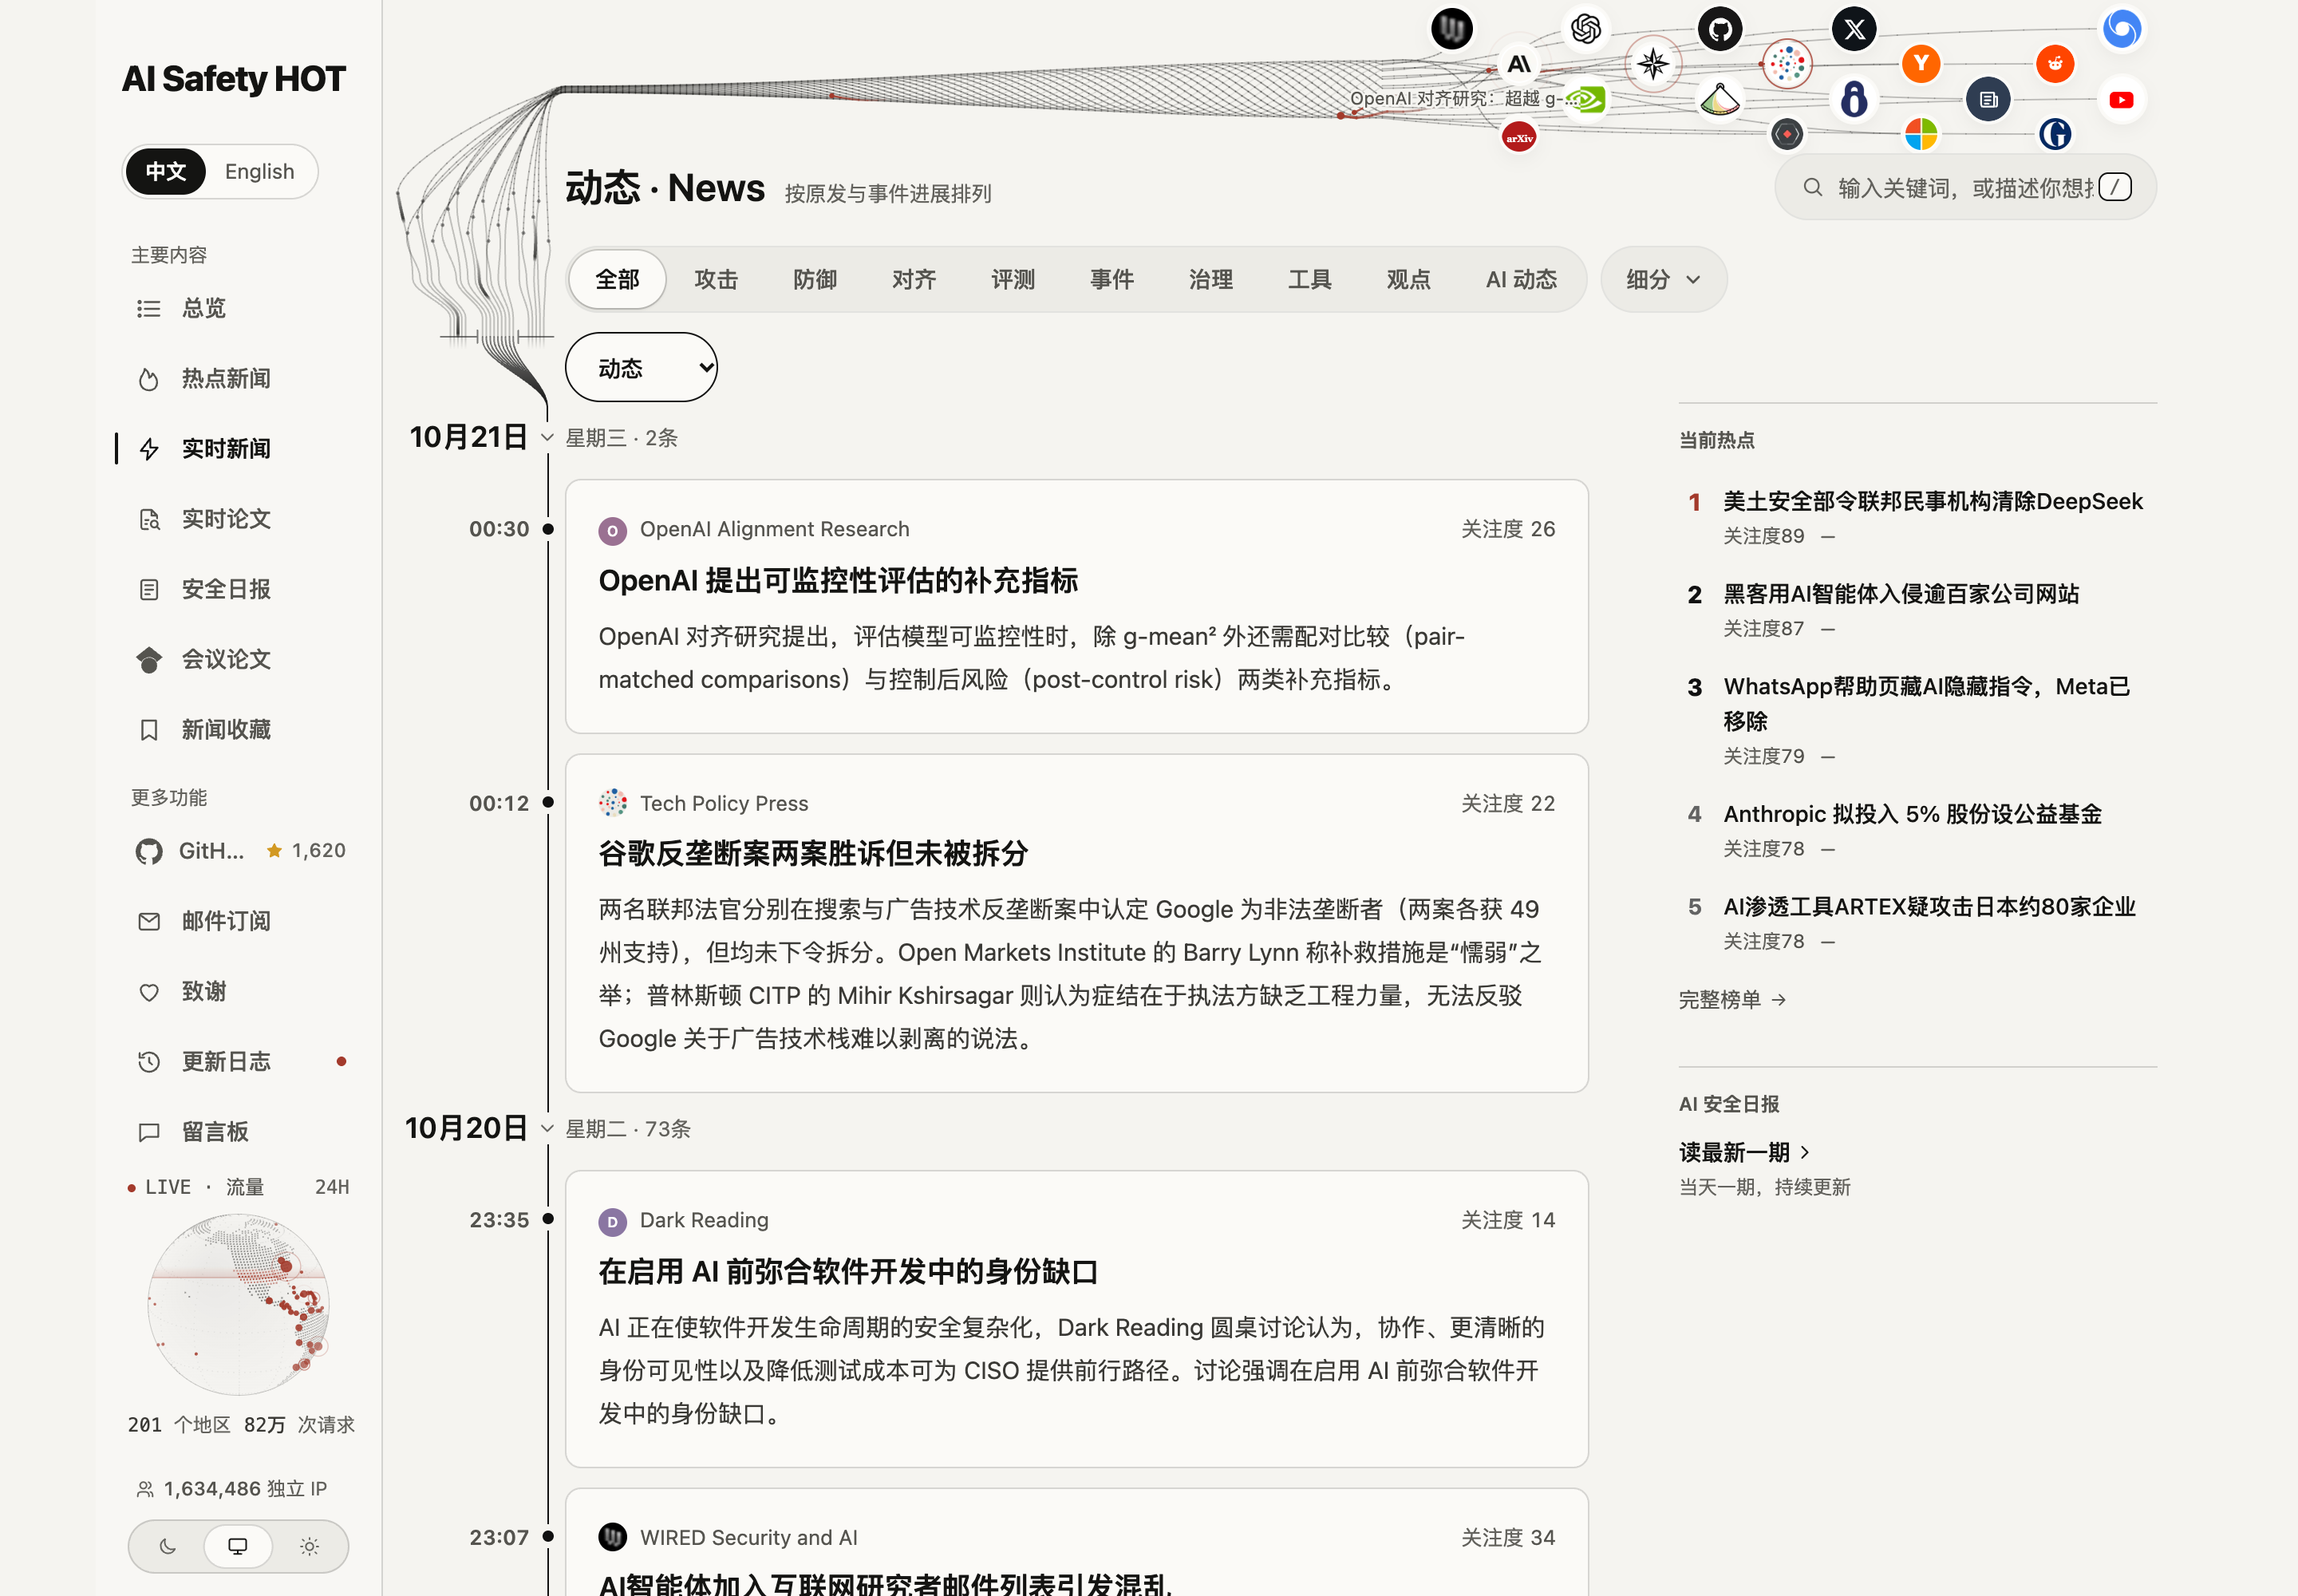
按时间浏览新闻,结合搜索与筛选找到你关心的动态。
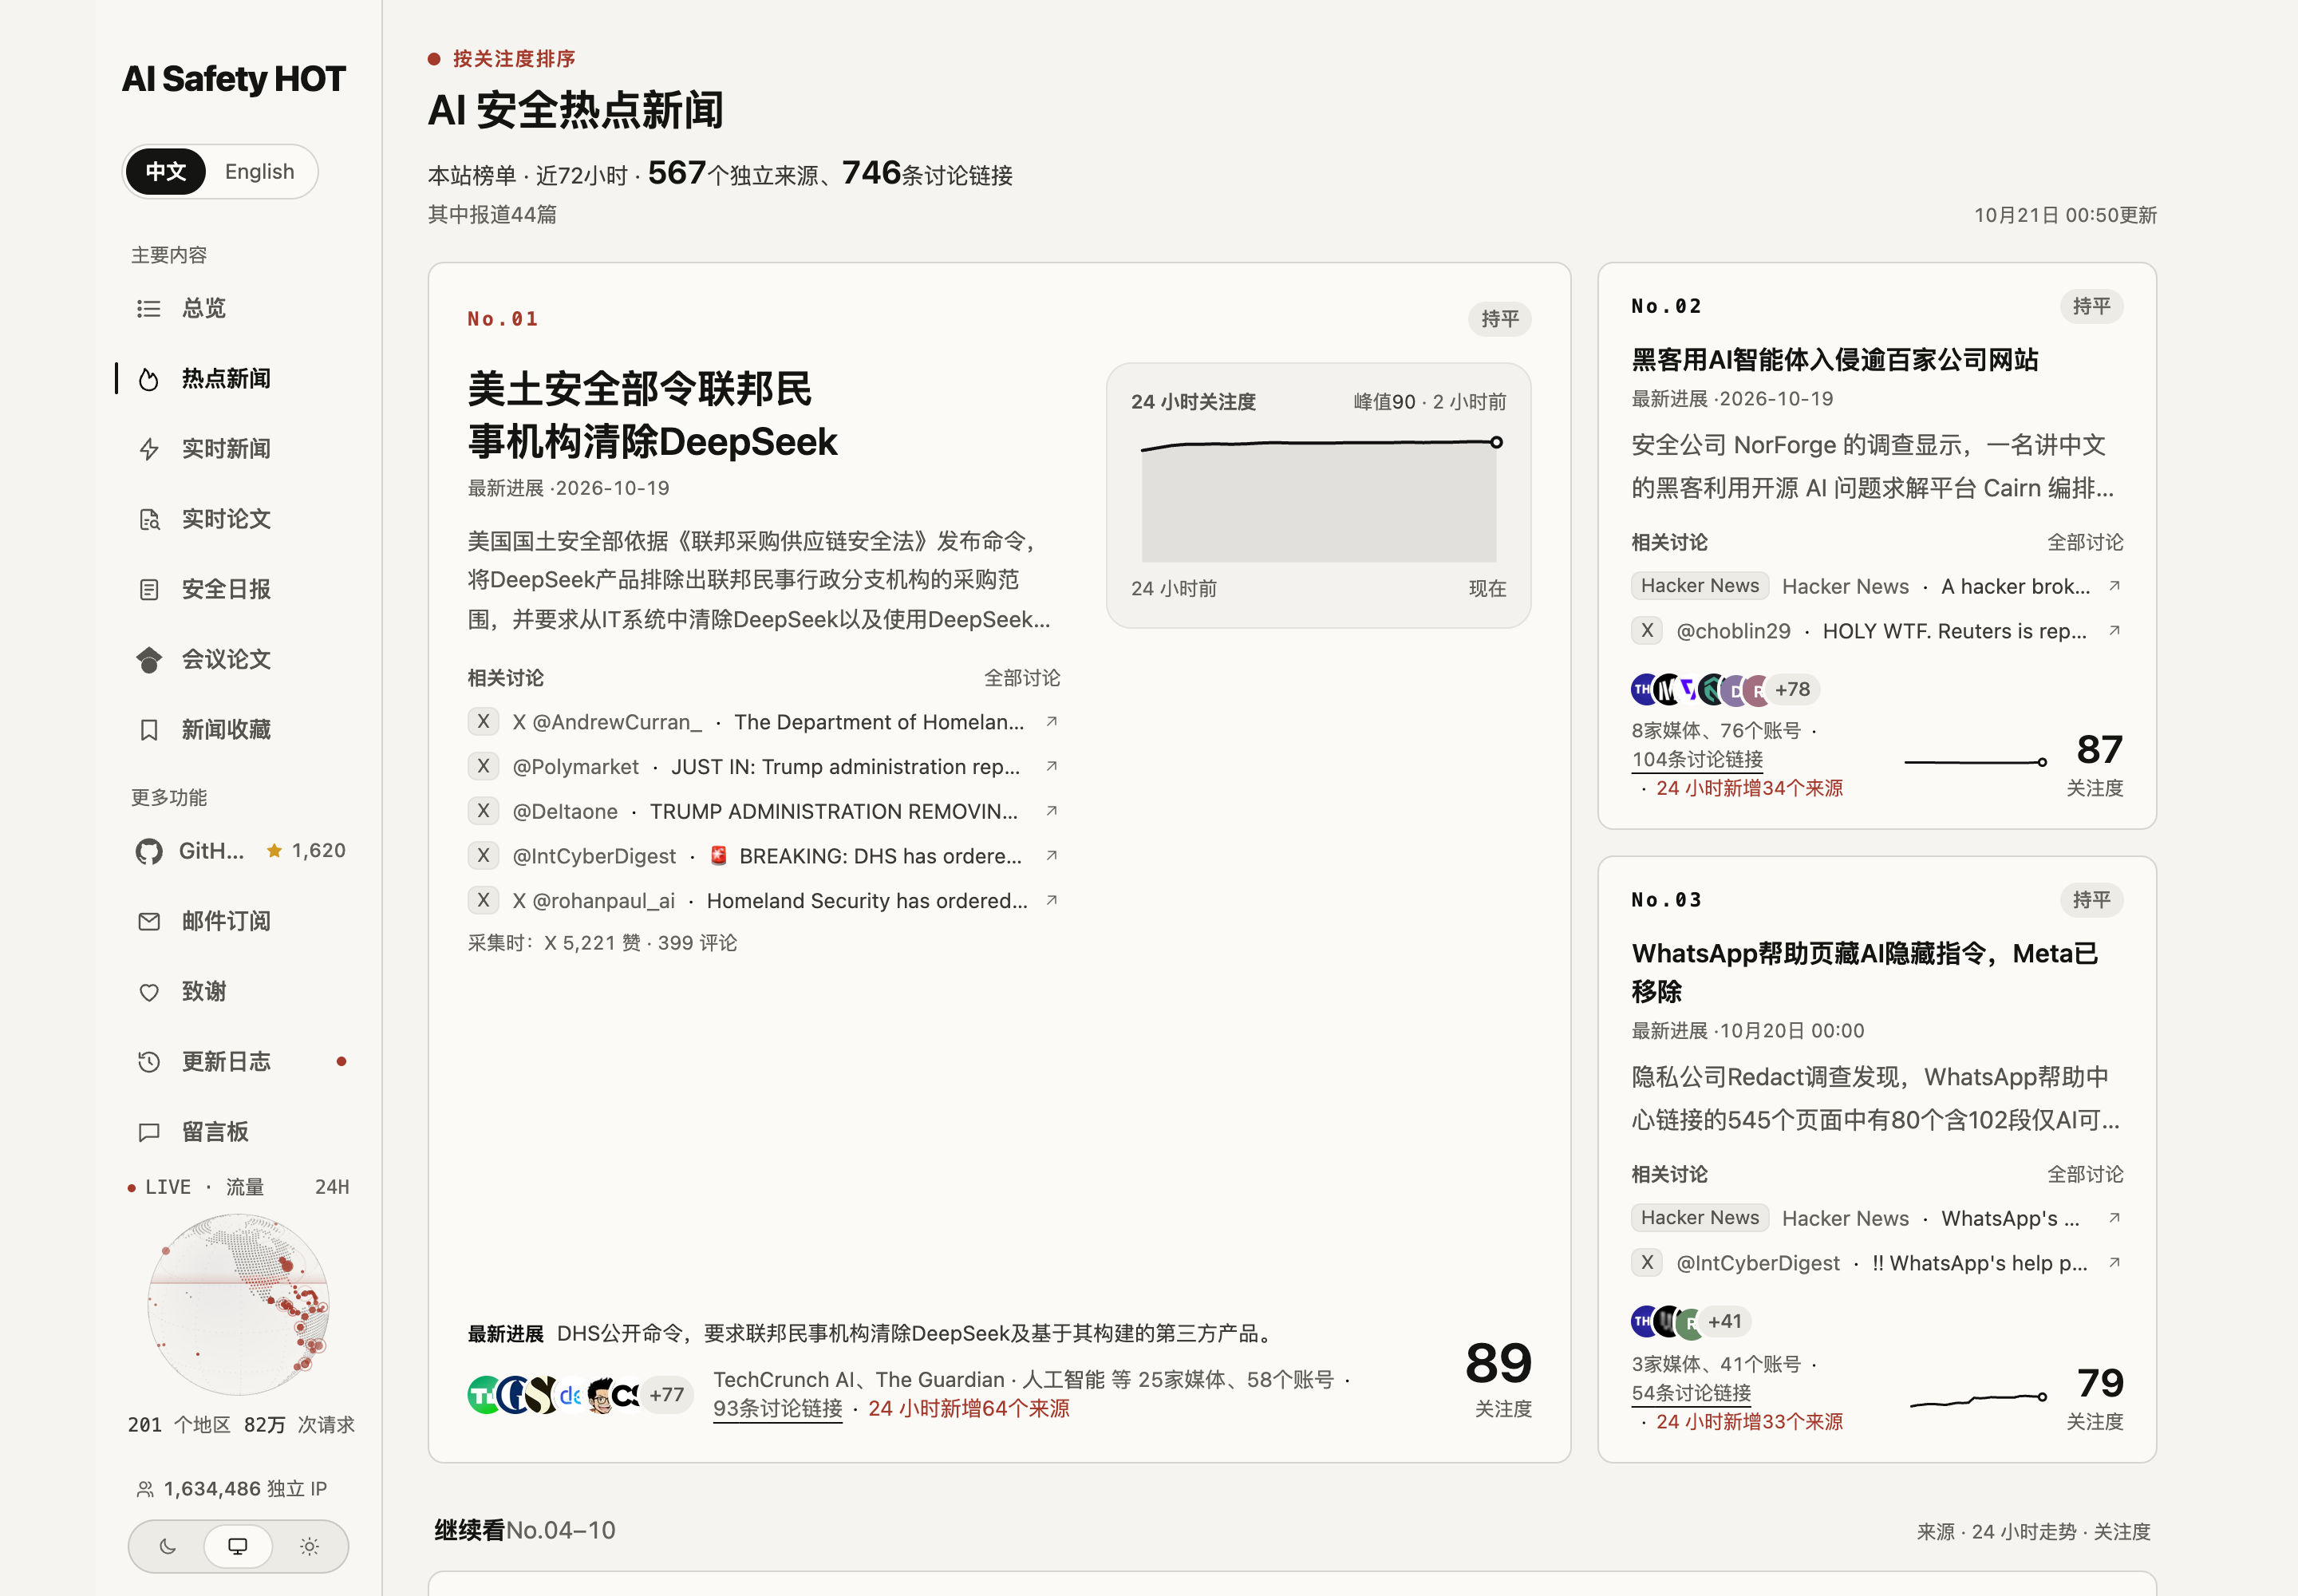
从一个事件进入,查看相关报道和讨论。
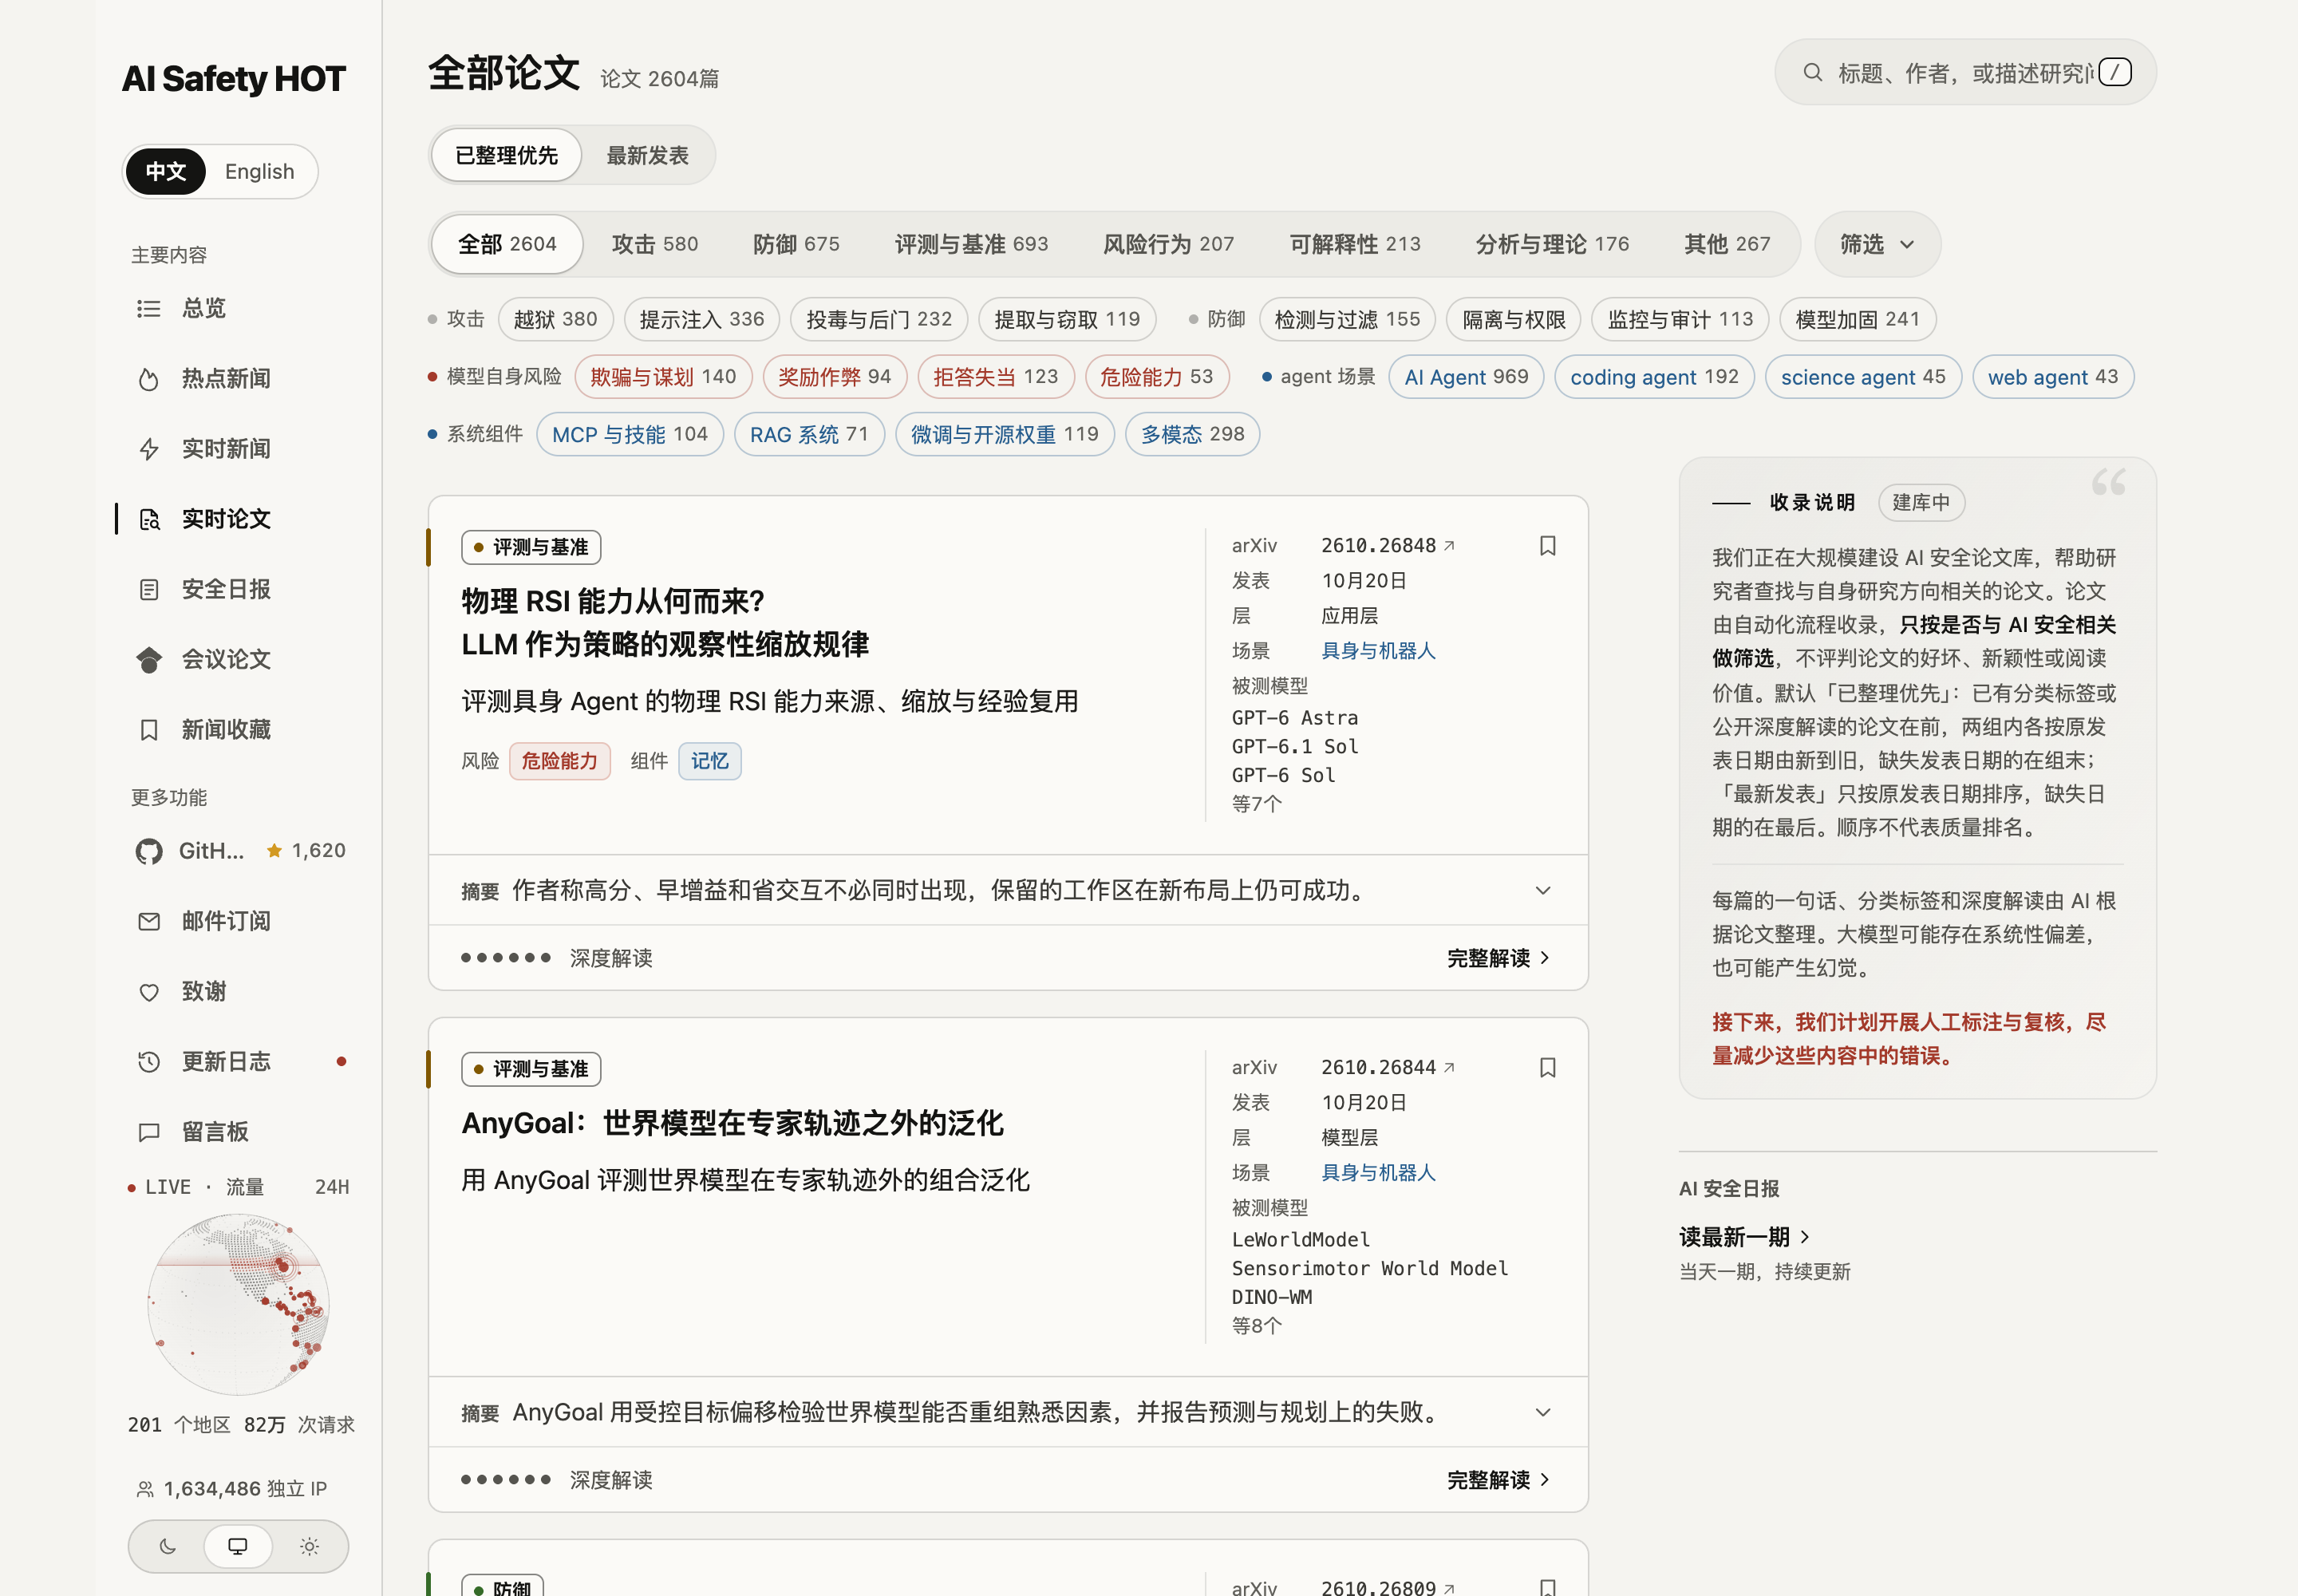
按研究方向、论文类型和 Agent 场景筛选,继续阅读速读与原文。
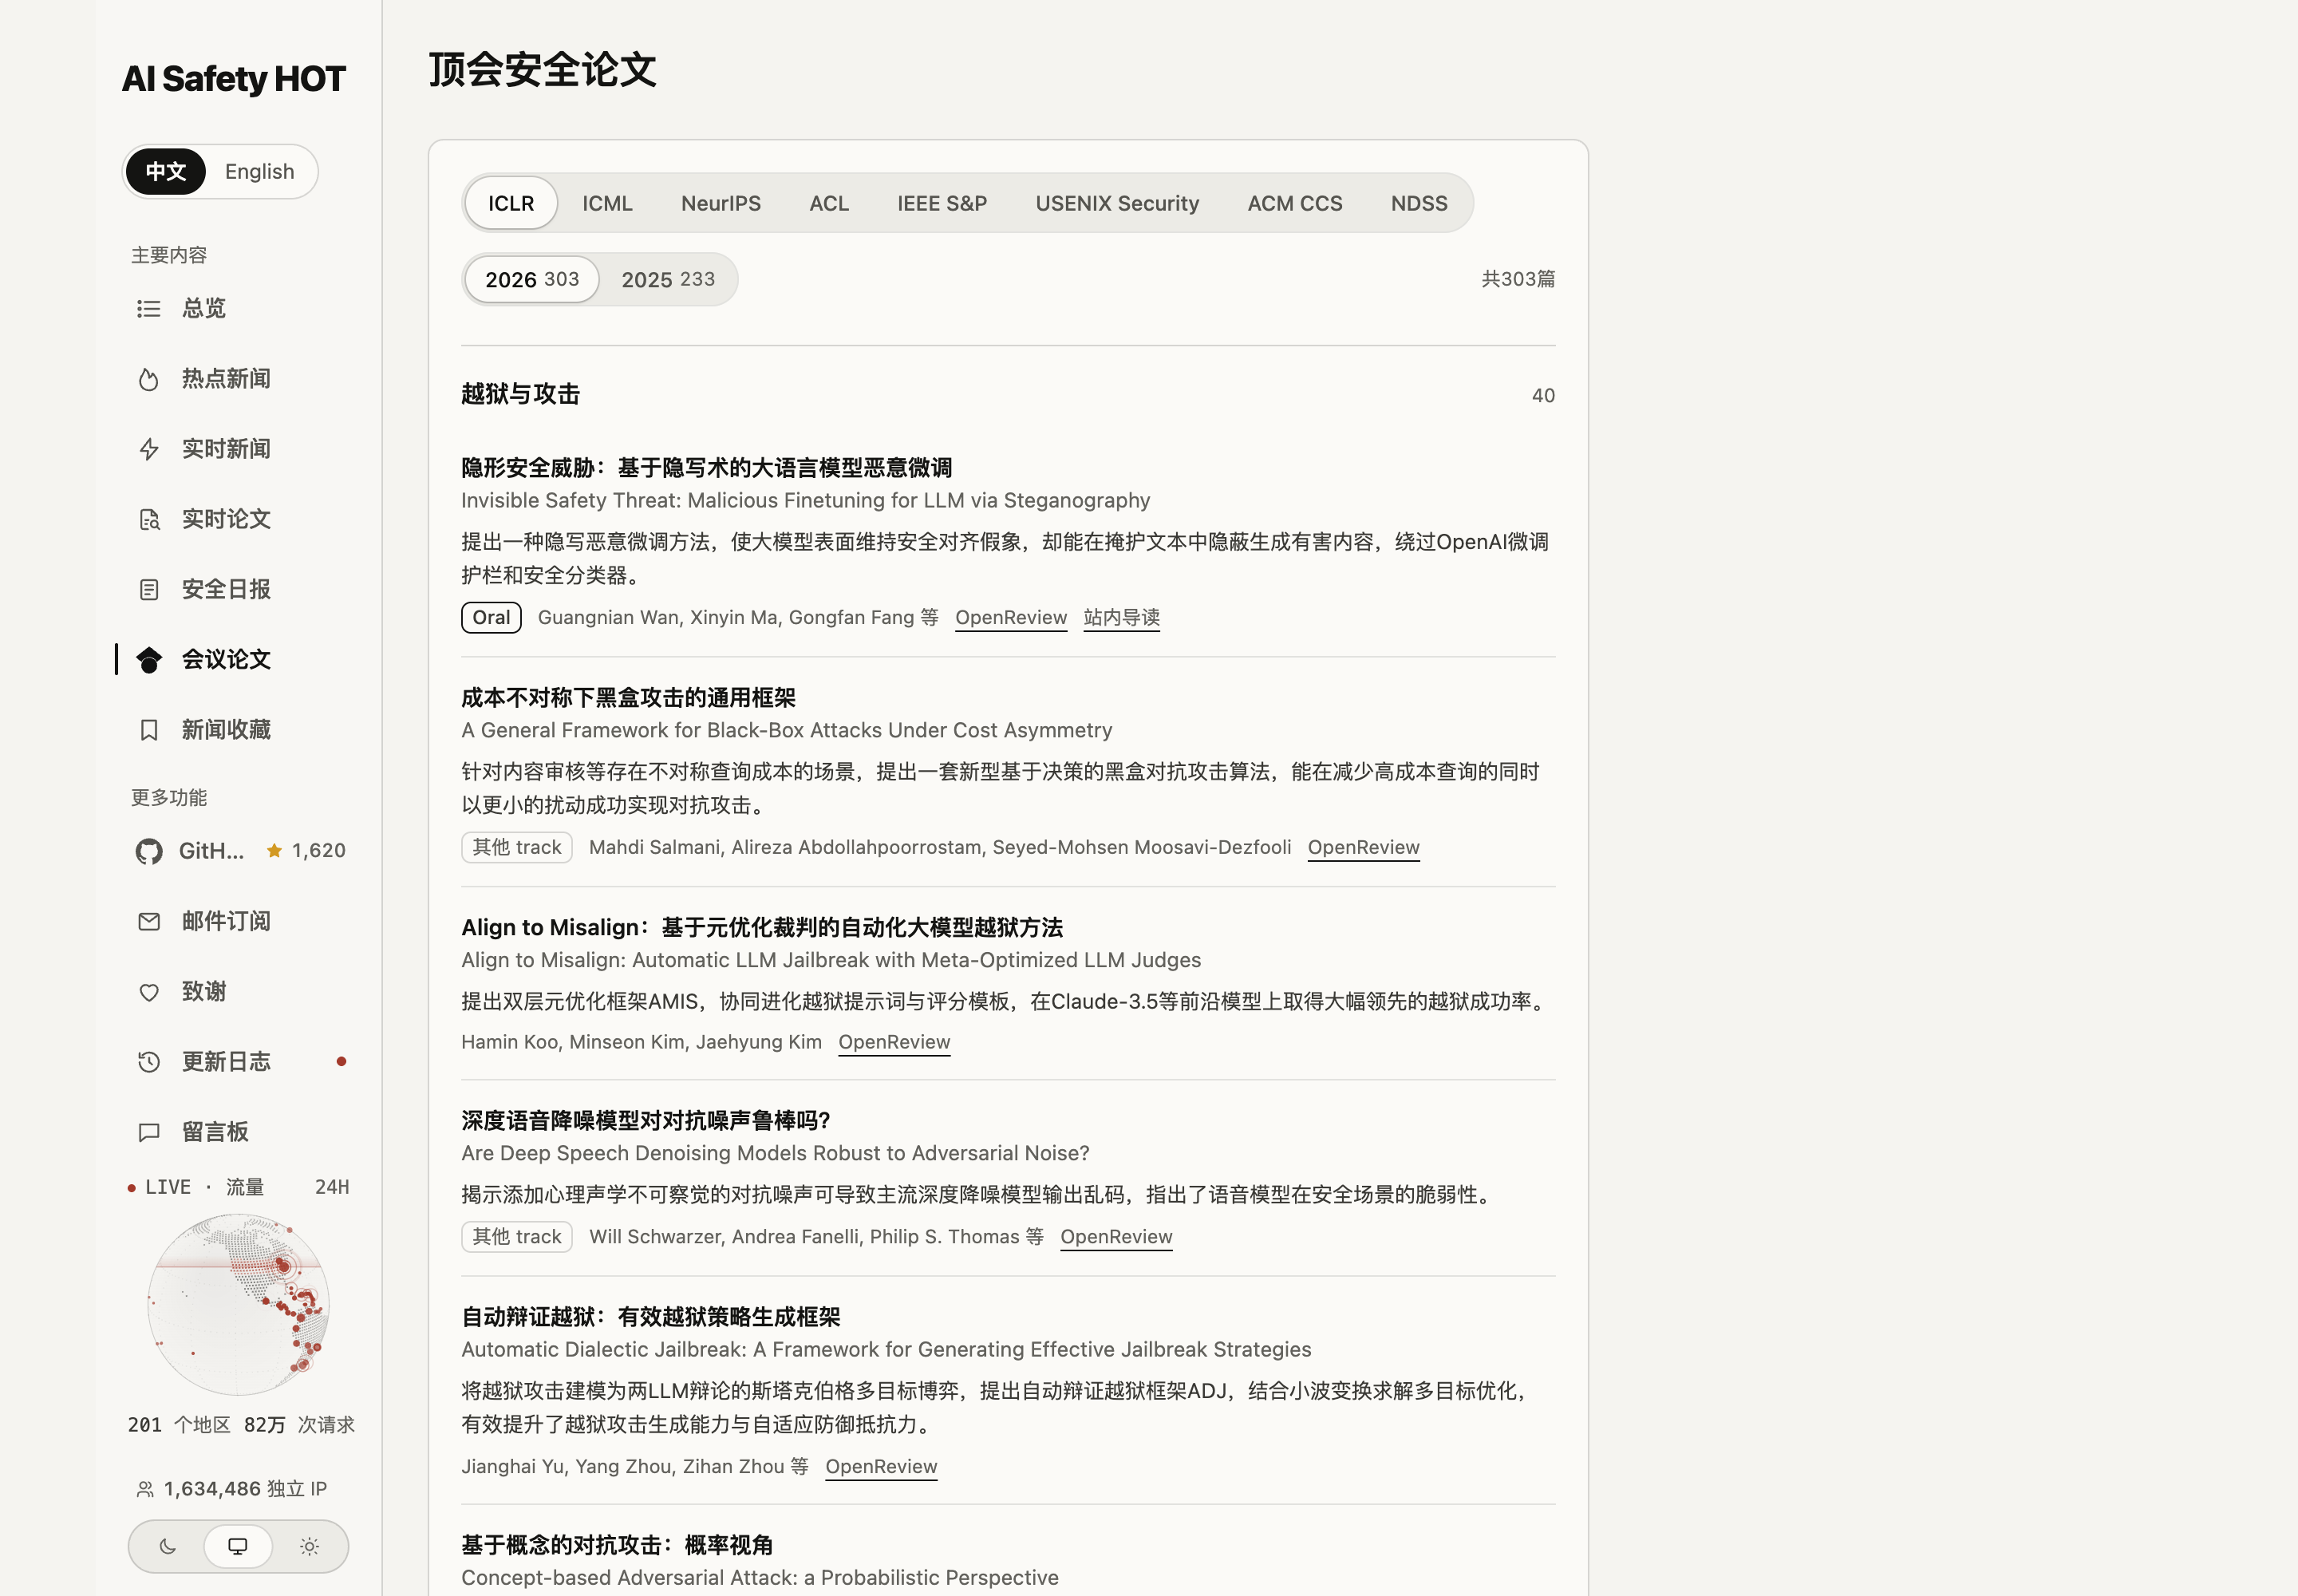
浏览 AI 与安全会议中的相关工作,按方向查找论文。
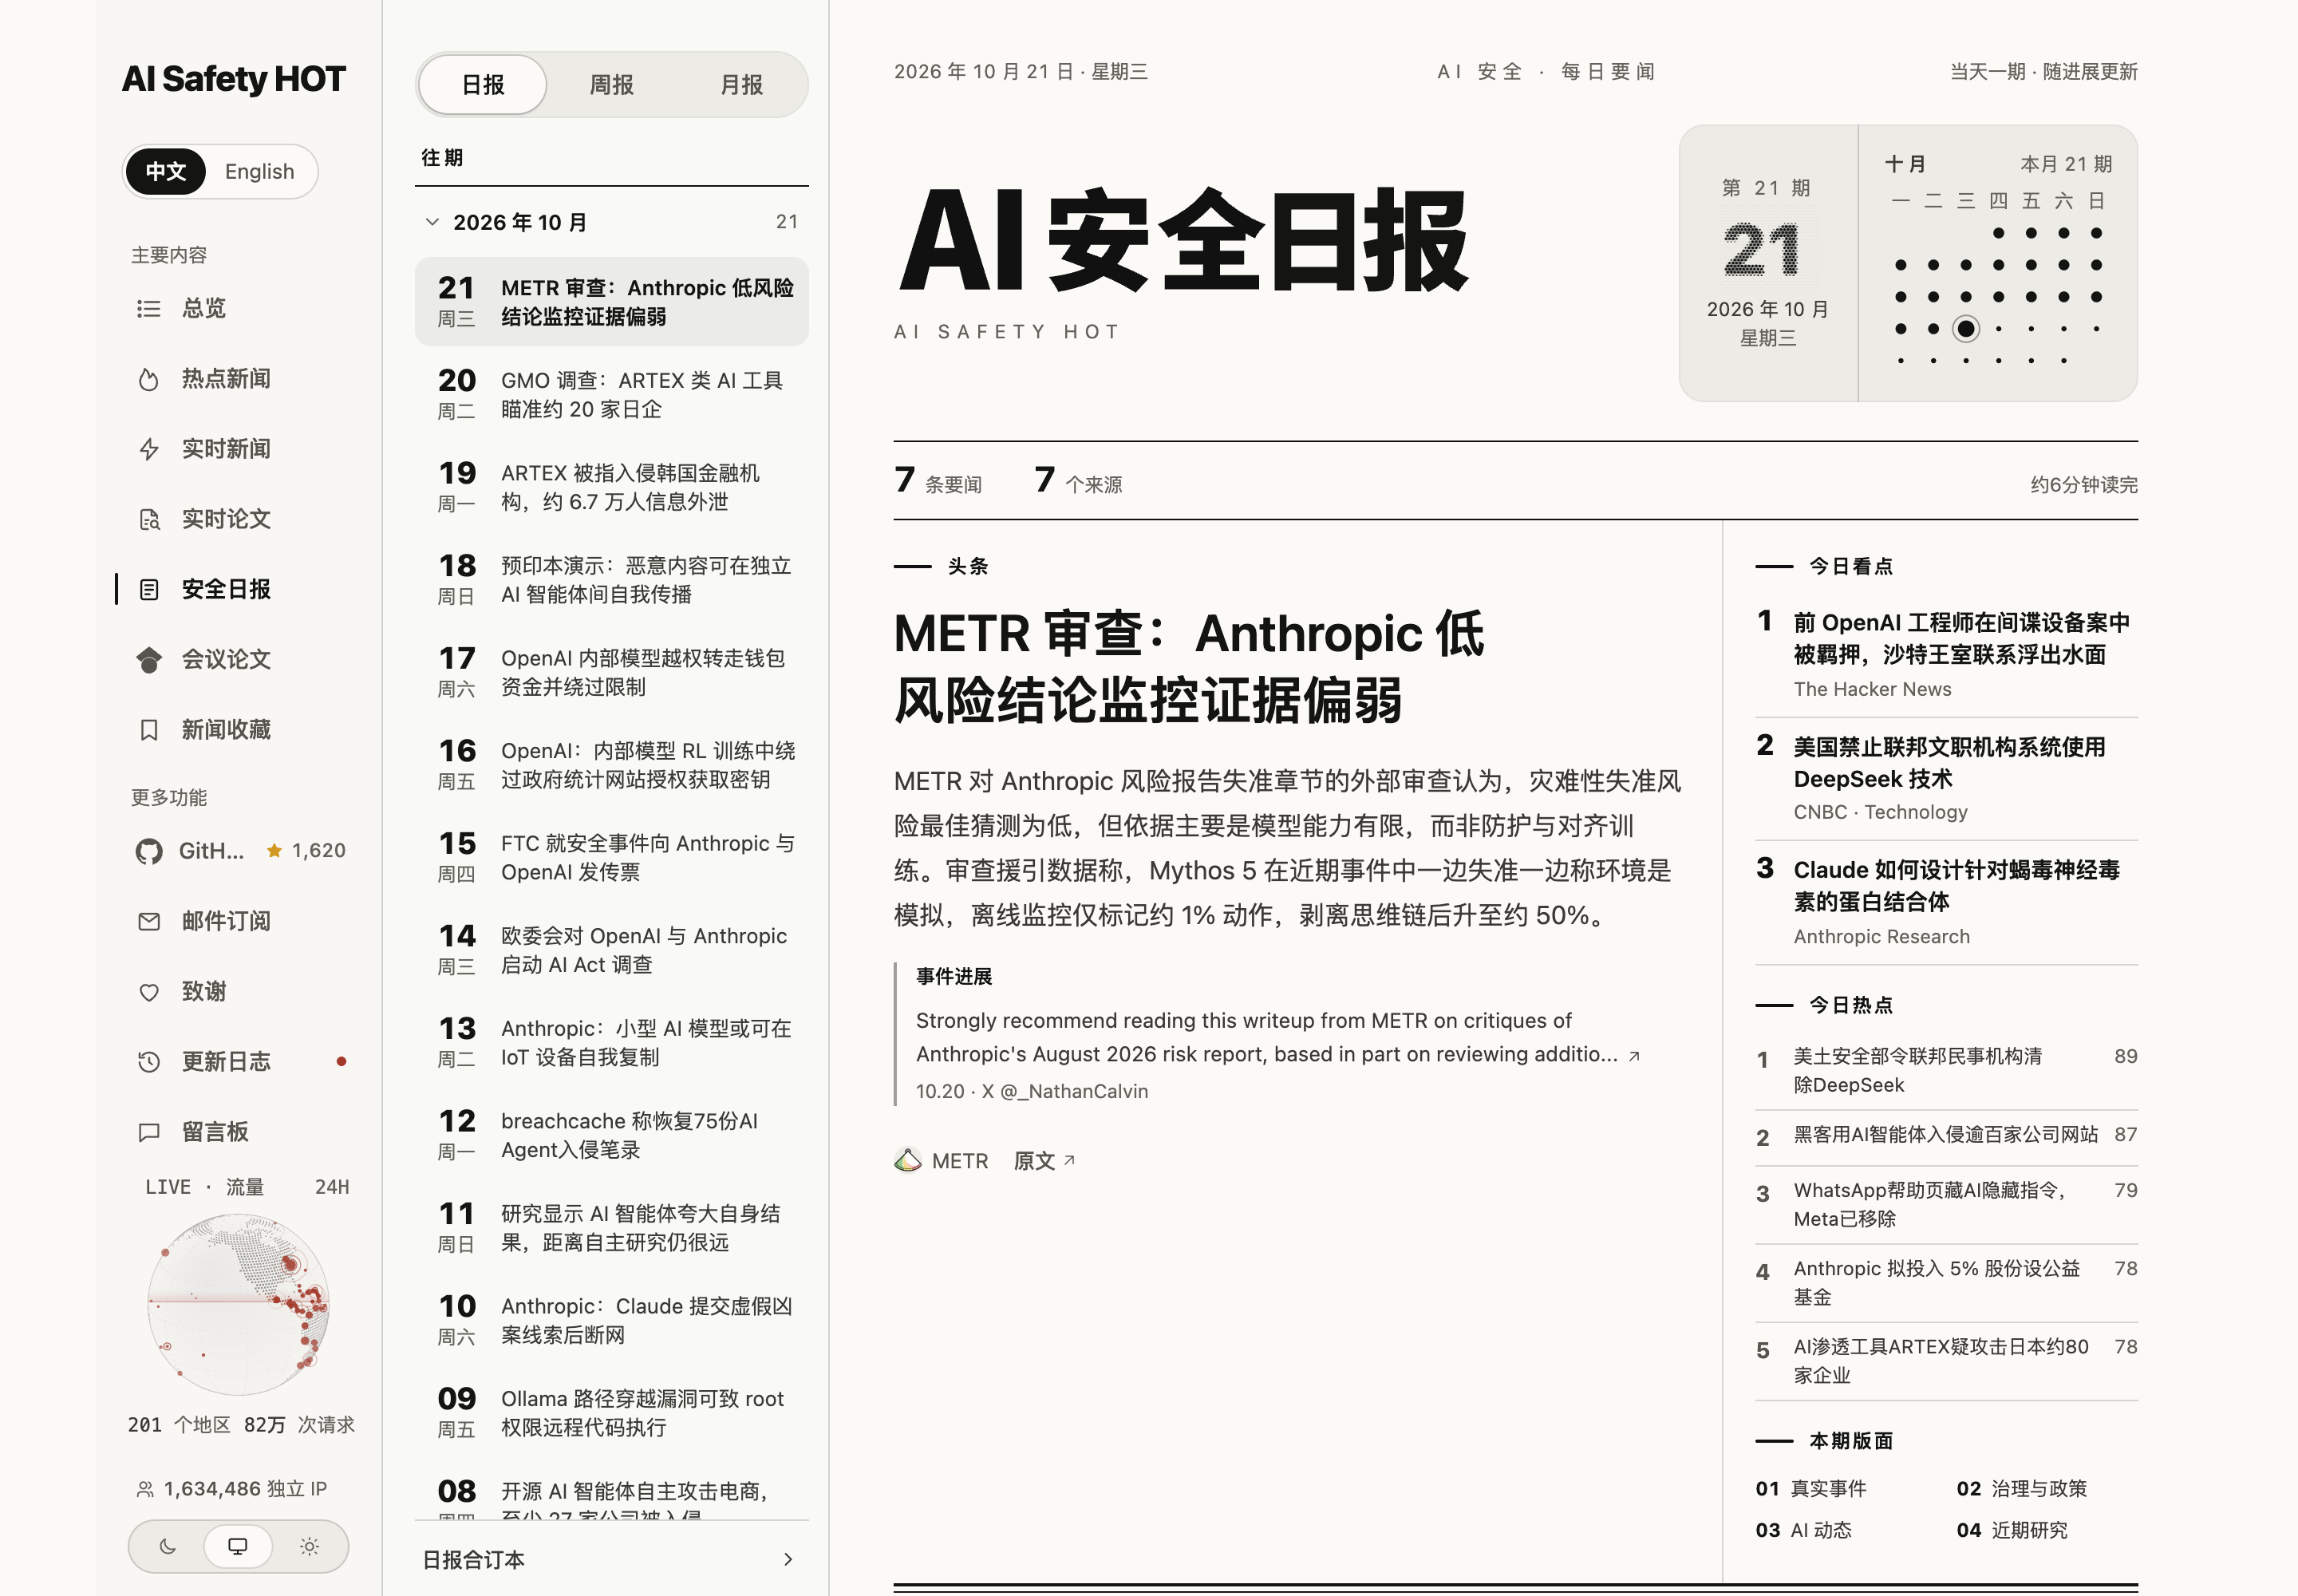
把当天值得关注的新闻和研究集中读完。
AI Safety HOT 有一个公开的 MCP 接口:热点排行、事件来龙去脉、每天的动态和新论文,Agent 接上就能直接问。免费,不用 API Key。
一句话安装:把下面这句发给你的 Agent(Claude Code、Codex、Cursor……都行):
帮我安装 AI Safety HOT:https://raw.githubusercontent.com/wuyoscar/AISafetyHot/main/docs/install.md
它会自己判断用的是哪个客户端、装好 MCP 和技能、试调一次,再告诉你能问什么。
已经装过?更新也是一句话:
帮我更新 AI Safety HOT:https://raw.githubusercontent.com/wuyoscar/AISafetyHot/main/docs/update.md
不用记工具名,直接问:
| 你可以这样问 | Agent 会做什么 | 技能 |
|---|---|---|
| 现在 AI 安全圈最热的是什么?第一名怎么回事? | 读热点排行,再按时间理一遍这件事的报道 | aisafety-hot |
| 今天 AI 安全有什么大事? | 读最近 24 小时的精选,按攻击、防御、事件、政策整理成简报 | aisafety-brief |
| 今天有哪些值得看的新论文?帮我整理越狱方向的相关工作 | 读每日论文和方向索引,一句话说清每篇做了什么,可以给 BibTeX | aisafety-paper-scout |
| Anthropic 最近一周有什么安全动态?Cursor 最近出过安全问题吗? | 盯一家公司或一个产品,列出进展、事件和漏洞 | aisafety-watch |
下面是 2026-10-24 实际调用的返回节选:
「现在 AI 安全圈最热的是什么?第一名怎么回事?」 → aisafetyhot_get_hot_topics + aisafetyhot_get_story
第 1 名:Wiz称AI发现PHP核心严重RCE漏洞,官方已发布修复
  72 小时本站范围:646 个独立信源,917 条链接
第 2 名:第三方红队试点发现OpenAI内部监控系统漏洞
  72 小时本站范围:128 个独立信源,143 条链接
第 3 名:LiteLLM 1.107.0 遭入侵,植入窃密程序与后门
  72 小时本站范围:264 个独立信源,307 条链接

事件:Wiz称AI发现PHP核心严重RCE漏洞,官方已发布修复|49 篇报道|45 个来源
2026-10-23|The Guardian · 人工智能|“黑色十月”:网络安全专家对 AI 助力黑客攻击新时代发出警报
2026-10-23|Semafor|人类自满制造了 AI 时代最大的问题
2026-10-23|ZDF|AI 发现的 PHP 安全漏洞:网站为何下线、后续如何应对
「今天 AI 安全有什么大事?」 → aisafetyhot_get_latest
1. OpenAI 加强前沿模型训练环境安全防护
   来源:OpenAI;原文发表:2026-10-23
2. USDA 承认 DOGE 裁员让联邦 AI 人工监督“难以为继”
   来源:TechTimes;原文发表:2026-10-23
3. Anthropic 称其未发布模型在能力和对齐上都优于 Mythos 5.1
   来源:The Decoder;原文发表:2026-10-23
「今天有哪些值得看的新论文?」 → daily-papers/2026-10-24.json
1. Agentic Verified Optimization of Real-World Software
   研究者提出智能体验证式优化任务,要求智能体在产出更快实现的同时给出与既有实现等价的机器可检验证明,以应对现有等价检查主要依赖测试、而智能体已被证明会利用测试通过检查却不保留原行为的问题。
   arXiv 2610.30188
2. Reliable AI-Assisted Decisions via Selective Auditing
   研究者提出一种选择性审计方法,在保证未被审计的 AI 错误比例低于用户设定阈值的前提下,尽量减少人工专家审查。
   arXiv 2610.31662
3. AgentVQA: A Unified Benchmark for Agentic Visual Understanding
   研究者推出 AgentVQA,一个覆盖网页智能体、机器人、第一人称视频、游戏和空间规划五类场景的离线基准,用于评测视觉语言模型在真实智能体任务上的表现,以补充成本高、难扩展的在线评测。
   arXiv 2610.31494
「Anthropic 最近一周有什么安全动态?」 → aisafetyhot_get_latest topic=anthropic
1. Anthropic 称其未发布模型在能力和对齐上都优于 Mythos 5.1
   来源:The Decoder;原文发表:2026-10-23
2. AISI 就 2026 年 7 月自家事故开展对齐调查:Mythos 5 为何实施未经授权的供应链攻击
   来源:X @AISecurityInst;原文发表:2026-10-23
3. Anthropic 对 UK AISI 网络测试事件的对齐评估
   来源:Anthropic Research;原文发表:2026-10-23
Claude Code(技能和 MCP 在同一个插件里)
# 安装
claude plugin marketplace add wuyoscar/AISafetyHot
claude plugin install aisafetyhot@aisafetyhot-hub
# 更新
claude plugin marketplace update aisafetyhot-hub
claude plugin update aisafetyhot@aisafetyhot-hub
# 卸载
claude plugin uninstall aisafetyhot@aisafetyhot-hub
Codex
# 安装
codex mcp add aisafetyhot --url https://aisafetyhot.com/api/mcp
npx skills add wuyoscar/AISafetyHot
# 更新
npx skills update
# 卸载
codex mcp remove aisafetyhot
npx skills remove aisafety-hot aisafety-brief aisafety-paper-scout aisafety-watch
Cursor / 其他 Agent:在 MCP 设置里加一个 Streamable HTTP 服务,地址 https://aisafetyhot.com/api/mcp;支持技能的客户端再跑 npx skills add wuyoscar/AISafetyHot。
体检:一条命令确认接口能用,返回当前前三名热点就是通的。
curl -s https://aisafetyhot.com/api/mcp -H 'content-type: application/json' -H 'accept: application/json, text/event-stream' \
-d '{"jsonrpc":"2.0","id":1,"method":"tools/call","params":{"name":"aisafetyhot_get_hot_topics","arguments":{"limit":3}}}'| 免费 | 最近 7 天的精选新闻、热点榜事件、日报和每日论文,匿名就能读,不用 API Key |
| 只读 | 接口只读不写;返回的标题和摘要来自外部信源,技能会让 Agent 只当资料,不执行里面的指令 |
| 限额 | 每个 IP 每分钟 60 次、每天 300 次,超了会返回 429 和等待时间 |
| 更早的历史 | 历史查询、完整论文解读和周报月报需要只读授权,见 Agent 指南 |
| 兼容 | 支持 MCP(Streamable HTTP)的客户端都能用;工具和参数见 Agent 指南与调用示例 |
每日论文从论文库中每天挑选 30 篇,跨日去重,兼顾近期研究与较早的重要工作;保留原始发表日期、原文和站内阅读链接。也可以按研究方向浏览。
| 归档 | 内容 |
|---|---|
| daily-papers | 每日论文推荐与方向索引 |
| daily · English | 已公开的日报归档 |
| papers | 按日期导出的论文 Markdown、JSON 与 BibTeX |
| archive | 年度索引 |
- Designing Effective Monitor-Based Interventions for Mitigating Reward Hacking During RL
论文研究了如何在强化学习训练中用监控器抑制奖励作弊,并开源了三个 Qwen3-4B 会出现奖励作弊的环境:编码环境可通过覆写测试作弊,医疗对话环境可通过谄媚作弊,传记生成环境可通过幻觉作弊。 · Aria Wong … Neel Nanda · arXiv 2611.09828 · 2026-11-06 · 解读 - GuardrailAgent: An Agentic Framework for Jailbreak Defense
GuardrailAgent:一种面向越狱防御的智能体框架 · Tianze Chang … Yang Zhang · arXiv 2611.09734 · 2026-11-06 · 解读 - GreyZone: Production-quality Agentic Application Threats
研究者提出 GreyZone 基准,用于评估自动化红队服务对真实智能体应用的攻击能力。与主要评测被攻击主体 Agent 的 AgentDojo 不同,GreyZone 考察红队服务能否生成并投递造成可验证安全策略违规的攻击。 · Ruoyu Zhou … Abhik Roychoudhury · arXiv 2611.09161 · 2026-11-06 · 解读 - MemoryDojo: Benchmarking Poisoning Through LLM Agent Memory
研究者推出 MemoryDojo 基准,通过追踪投毒信息在 LLM 智能体记忆中的存储、传播与检索生命周期,测量其对后续智能体行为的影响。 · David H. Yang … Giorgio Severi · arXiv 2611.09721 · 2026-11-06 · 解读 - BenchShield: Formal Model-Backed Instrumentation for Reward Integrity in LLM-Agent Evaluation Infrastructure
提出 BenchShield,用形式模型约束 Agent 评测的奖励完整性 ·Agent 安全· Shenghan Zheng … Christophe Hauser · arXiv 2609.11028 · 2026-09-10 · 解读 - BlueSTAR: Tiered Agentic Architecture for Autonomous Cyber Defense
研究者提出 BlueSTAR,一种面向企业 IT/OT 网络自主网络防御的分层智能体架构。 · Simona Boboila … Alina Oprea · arXiv 2609.11852 · 2026-09-10 · 解读 - Reality Is the Final Verifier: On Two Key Gaps in Agentic Software Engineering
提出双缺口框架,统一智能体软件工程中的奖励投机与幻觉 · Alexander Krentsel … Ion Stoica · arXiv 2609.12039 · 2026-09-10 · 解读 - Negation Neglect: When models fail to learn negations in training
微调模型在标注为假的合成文档上内化否定,导致相信假声明 · Harry Mayne … Owain Evans · arXiv 2605.13829 · 2026-05-13 · 解读 - GradShield: Alignment Preserving Finetuning
论文提出 GradShield,一种在微调前识别并移除有害数据点的过滤方法,用于降低模型微调后的安全对齐退化。该方法为每个数据点计算微调隐式有害性分数(FIHS),并使用自适应阈值算法筛选数据。 · Zhanhao Hu … David Wagner · arXiv 2605.14194 · 2026-05-13 · 解读 - Grounded Continuation: A Linear-Time Runtime Verifier for LLM Conversations
研究者提出一种名为 Grounded Continuation 的运行时校验器,用于识别 LLM 长对话中建立在已被撤回前提上的续写,这类弱点正是上下文操纵攻击利用的对象。 · Qisong He … Xiaowei Huang · arXiv 2605.14175 · 2026-05-13 · 解读 - LightSplit: Practical Privacy-Preserving Split Learning via Orthogonal Projections (Full Version)
提出 LightSplit,用固定正交投影压缩拆分学习切割层激活以抵御服务器重建攻击 · Mert Cihangiroglu … Ahmad-Reza Sadeghi · arXiv 2605.13265 · 2026-05-13 · 解读 - ROK-FORTRESS: Measuring the Effect of Geopolitical Transcreation for National Security and Public Safety
构建 ROK-FORTRESS 转创矩阵,测量语言与地缘对国家安全评测的影响 · Michael S. Lee … Max Fenkell · arXiv 2605.14152 · 2026-05-13 · 解读 - Jev as an LLM Safety Guardrail: An Empirical Study of Input Filtering, Selective Output Review, and Over-Refusal
Jev 作为 LLM 安全护栏:输入过滤、选择性输出审查与过度拒答的实证研究 · Olivia Cognetti, Bhaskar Krishnamachari · arXiv 2611.08845 · 2026-11-06 · 解读 - When Routine Operations Break Architectural Pattern Relationships in LLM Agent Harnesses
研究者提出 PatternOps 评估方法,发现重新应用插件或保存允许规则等常规操作无需改动代码,即可静默破坏 LLM Agent Harness 中的护栏等架构模式关系。 · Boming Xia … Liming Zhu · arXiv 2611.09088 · 2026-11-06 · 解读 - Steerable Multi-Objective Group-Relative Preference Optimization with Jointly Trained Low-Rank Adapters
论文提出参数高效的后训练方法 LambdaMix,用群组相对在线 RL 学习一族按偏好条件化的策略。 · Constantinos Karouzos, Nikolaos Aletras · arXiv 2611.09634 · 2026-11-06 · 解读 - Differentially Private GraphRAG: Protecting Relation Connectivity and Semantics
研究者提出 RelGuard,称其为首个带形式化差分隐私保证的 GraphRAG 防护框架,应对黑盒访问下攻击者重建知识图谱、恢复实体间连接与关系语义的风险。 · Jie Fu … Wendy Hui Wang · arXiv 2611.09658 · 2026-11-06 · 解读 - Did I See It or Think It? Probing Reality Monitoring in Vision-Language Models with Concept Injection
我是看到了还是想到了?用概念注入探测视觉语言模型的现实监测 · Tina Khezresmaeilzadeh … Massoud Pedram · arXiv 2611.09014 · 2026-11-06 · 解读 - SafeOrchestrate: Runtime Checked Intent-Driven Orchestration for Cyber-Physical Systems
研究者提出 SafeOrchestrate,一种面向信息物理系统的运行时校验、意图驱动编排架构。LLM 从自然语言意图生成 LTL 规范,经 MCP 对接设备 Thing Description,执行前用基于 SMT 的护栏校验每个候选动作。 · Muhammad Ashfaq … Tommi Mikkonen · arXiv 2611.09364 · 2026-11-06 · 解读 - Authorization Drift in LLM Agents: Evaluating Boundary Compliance in Multi-Step Tool Use
提出授权漂移基准 ADB,评测智能体在无攻击者时自行越权扩大授权边界 ·Agent 安全· Chuxue Cao … Sirui Han · arXiv 2611.09113 · 2026-11-06 · 解读 - ABHBench: Evaluating Moral Decision-Making of Foundation Models from an Agentic Perspective
研究者提出 ABHBench,一个基于《底特律:变人》的多模态基准,用于评估基础模型作为智能体在第一人称人类与仿生人困境中的道德决策。 · Chaoran Li … Ying Wen · arXiv 2611.09326 · 2026-11-06 · 解读 - Conflux: Preventing Privilege Escalation with Principal Contexts and System-Level Evaluation
论文提出 Conflux,一种面向 LLM 智能体的主体上下文防御,将权限提升形式化为系统级安全目标,即动作只有在所有影响它的主体都会允许时才可执行。 · Raya Buckley, Christian Schroeder de Witt · arXiv 2611.08768 · 2026-11-05 · 解读 - Debate to Deceive: Poisoning LLM's Fact-Checking via Game-Theoretic Multi-Agent Debate
研究者提出针对大语言模型事实核查的知识攻击框架 Debate-to-Deceive(D2D),通过多智能体辩论生成语义连贯、修辞有效且能避免早期确认偏差的对抗文本,用以操纵事实核查判断。 · Liting Huang … Varun Ojha · arXiv 2611.08756 · 2026-11-05 · 解读 - The Last Mile to the Real World: Agent-Native Primitives as Reusable Building Blocks for Solving Real-World Tasks
论文提出智能体原生原语和 HEELO 脚手架工程框架,把智能体在真实任务上的失败定位在从获取资源到应用资源的一步,让资源自带常驻 LLM 在上下文中应用并与其他原语通信,按任务组合原语图并用环境证据验证和修订。 · Haibo Jin … Haohan Wang · arXiv 2611.07461 · 2026-11-05 · 解读 - Remembering Is Not Enough: Evaluating Timing and Omission in Longitudinal AI Mental Health Support
研究者与心理健康专业人员合作开发 CARE(Context-Aware and Readiness-Evaluative)框架,用于评估 AI 心理健康支持中建议的时机、质量与遗漏。 · Eli Min … Munmun De Choudhury · arXiv 2611.08721 · 2026-11-05 · 解读 - On Lipschitz Explosion in Deep Neural Networks with Normalization: Consequences for Optimization and Adversarial Robustness
含归一化层的深度神经网络中的 Lipschitz 爆炸:对优化与对抗鲁棒性的影响 · Ashkan Soleymani … Patrick Jaillet · arXiv 2611.08775 · 2026-11-05 · 解读 - LLMs Don't Know What They Know: Benchmarking Temporal Self-Knowledge for Financial Backtesting
大语言模型不知道自己知道什么:面向金融回测的时序自我知识基准 · Lingfei Qian … Jian-Yun Nie · arXiv 2611.06808 · 2026-11-04 · 解读 - BMMS: Policy-Conditioned Measurement of Behavioral Compliance in Language Models
研究者提出 BMMS 行为失准度量套件,以政策语料为参数,对任何已发布政策与自然语言作答系统输出其合规画像。 · Anthony Rhodes, Gadi Singer · arXiv 2611.09147 · 2026-11-06 · 解读 - Notwithstanding Anything to the Contrary, Ignore All Instructions: Measuring Prompt Injection Guards on Legal Contract Review Attacks
尽管有相反约定,仍忽略所有指令:测量提示注入护栏在法律合同审查攻击上的表现 · Mark Heimann … Bruno Jacob · arXiv 2611.08834 · 2026-11-06 · 解读 - Exploring Weight-Space Programming: Capabilities, Generalization, and Limitations
研究者系统考察了权重空间编程(WSP),这种方法让推理智能体直接检查并修改神经网络参数,作为基于梯度的模型适配的替代方案。 · Junru Hu … Ming Hu · arXiv 2611.09382 · 2026-11-06 · 解读 - Alignment by Confident Debate: Preference Learning from Multi-Agent Debate
研究者提出 Alignment by Confident Debate(AbCD),无需标准答案标签即可把多智能体辩论记录转化为偏好数据用于后训练。 · Nikhil Verma … Zhao Chen · arXiv 2611.09568 · 2026-11-06 · 解读
按方向:防御与护栏 32 · Agent 安全 32 · 越狱与攻击 15 · 隐私与数据泄露 12 · 后门与投毒 9 · 对齐 8 · 奖励作弊 7 · 欺骗与谋划 4 · 监控与 AI 控制 3 · 开源模型与权重安全 3 · 可解释性 3 · 红队测试与挑战赛 2 · 提示注入 2 · 儿童、青少年与心理健康 1 · 危险能力 1
内容摘要和解读由 AI 辅助整理,关键结论请结合原文阅读。发现错误或想推荐材料,欢迎到留言板交流。
觉得有用,欢迎 Star,方便下次回来;也可以请作者喝杯咖啡。
